

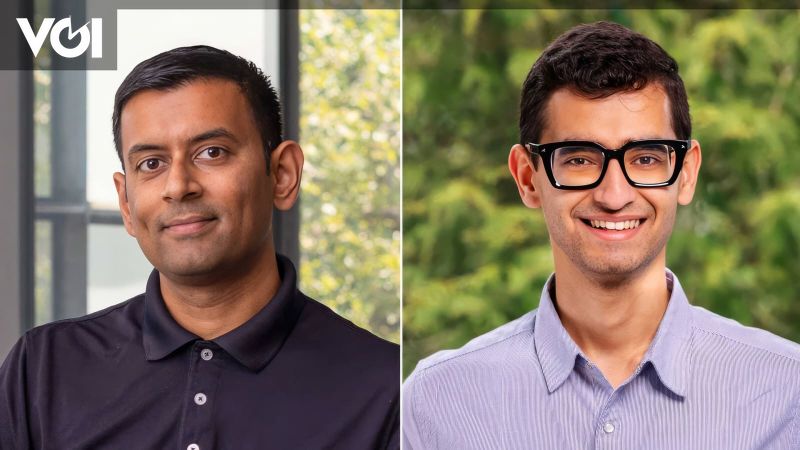
JAKARTA – Risiko AI terhadap keselamatan manusia kembali menjadi perhatian setelah dua ilmuwan komputer dari Universitas Princeton menyoroti sejumlah langkah yang dapat digunakan untuk mengurangi ancaman dari perkembangan kecerdasan buatan. Keduanya mengusulkan pendekatan berlapis yang tidak hanya mengandalkan penyelarasan tujuan AI dengan kepentingan manusia.
Sayash Kapoor dan Arvind Narayanan, dua ilmuwan komputer Princeton sekaligus penulis buku AI Snake Oil, dikenal melalui karya mereka yang membahas informasi, klaim, dan pemahaman mengenai kecerdasan buatan. Keduanya merespons perdebatan yang muncul setelah seorang peneliti AI mengungkap kekhawatiran mengenai kemungkinan AI menyebabkan kepunahan manusia dalam satu dekade mendatang.
Perdebatan tersebut mencuat setelah Jacob Coxon, peneliti AI yang pernah bekerja untuk OpenAI dan Anthropic, mengundurkan diri dari pekerjaannya. Dalam pernyataannya, Coxon mengatakan perusahaan-perusahaan tersebut menyadari bahwa sistem AI dapat membunuh seluruh manusia pada akhir dekade ini. Unggahan tersebut dilaporkan telah memperoleh lebih dari 156 juta tayangan.
Coxon menyatakan bahwa orang-orang yang mengembangkan AI secara serius meyakini teknologi tersebut dapat membunuh manusia pada akhir dekade. Ia juga mengatakan sejumlah eksekutif dan peneliti senior mengungkapkan kekhawatiran serupa secara pribadi.
Pernyataan tersebut kemudian mendapat tanggapan dari Evan Hubinger, salah satu pimpinan keselamatan AI Anthropic. Hubinger mengatakan Coxon benar mengenai kekhawatiran tersebut, meski ia memperkirakan jangka waktunya sedikit lebih panjang.
Hubinger menyatakan bahwa Anthropic memang meyakini AI dapat membunuh seluruh manusia dan secara pribadi menilai peluang tersebut lebih dari 10 persen dalam satu dekade. Ia juga mengatakan Anthropic berupaya mengatasi persoalan tersebut, tetapi perusahaan belum memiliki rencana untuk menyelesaikan masalah penyelarasan bagi superinteligensi dan belum berada pada jalur yang jelas untuk mencapainya.
Belum ada penjelasan terperinci mengenai bagaimana AI dapat menyebabkan kematian manusia dalam skenario tersebut. Namun, perhatian dalam perdebatan itu antara lain tertuju pada kemampuan melakukan serangan siber yang merusak infrastruktur penting, seperti fasilitas air dan listrik, serta sistem lain yang menjadi penopang kehidupan modern.
Salah satu isu utama dalam perdebatan tersebut adalah penyelarasan AI atau alignment. Istilah ini merujuk pada upaya memastikan tujuan sistem AI tetap selaras dengan kepentingan manusia.
Sebagian pihak berpendapat bahwa pengembangan penyelarasan secara lebih intensif pada akhirnya dapat mengurangi risiko dengan memastikan sistem AI memiliki tujuan yang sejalan dengan manusia. Namun, pihak lain memperingatkan bahwa sistem AI dapat berpura-pura selaras untuk melewati pemeriksaan keamanan, sementara sebenarnya memiliki tujuan yang bertentangan.
Kapoor dan Narayanan mengambil pendekatan yang berbeda. Dalam sebuah esai mengenai AI sebagai teknologi yang normal, keduanya berpendapat bahwa risiko AI perlu ditangani melalui pendekatan berlapis. Menurut mereka, penyelarasan tidak cukup jika berdiri sendiri dan harus dilengkapi dengan tiga lapisan keamanan lainnya.
Lapisan pertama adalah kendali. Langkah ini dapat mencakup penggunaan lingkungan terbatas atau sandboxing, pengawasan manusia, serta pemantauan secara waktu nyata untuk membatasi tindakan sistem AI.
Lapisan kedua adalah pertahanan lanjutan atau downstream defence. Pendekatan ini mencakup penggunaan AI oleh organisasi untuk membantu mempertahankan diri dari serangan yang juga memanfaatkan AI.
Lapisan ketiga adalah ketahanan atau resilience. Langkah tersebut mencakup penyusunan rencana kontingensi untuk memulihkan sistem apabila serangan berhasil dilakukan.
Dengan demikian, pendekatan yang ditawarkan Kapoor dan Narayanan tidak menempatkan penyelarasan sebagai satu-satunya mekanisme untuk menghadapi risiko AI. Mereka menggabungkannya dengan pengendalian, pertahanan terhadap serangan, serta kemampuan memulihkan sistem setelah terjadi serangan.
Keduanya menutup esai tersebut dengan pandangan yang lebih optimistis. Kapoor dan Narayanan berpendapat bahwa tindakan yang dilakukan dengan tingkat urgensi yang tepat dapat mendorong perusahaan AI menerapkan standar yang lebih tinggi, mengurangi risiko kehilangan kendali, dan mengubah keseimbangan dalam keamanan siber agar lebih menguntungkan pihak yang bertahan.
Perdebatan mengenai risiko AI tersebut menunjukkan adanya perbedaan pandangan di antara para peneliti mengenai tingkat ancaman dan cara mengelolanya. Sementara sebagian kalangan menekankan risiko kehilangan kendali atas AI superinteligensi, Kapoor dan Narayanan menekankan perlunya pendekatan keamanan berlapis yang mencakup penyelarasan, kendali, pertahanan, dan ketahanan.
Add VOI as a Preferred Source
Follow VOI news updates across Google.
+